Markdown 并不适合科学写作
写作的格式工具会悄悄影响到你的行文组织方式。Markdown 与其说「不适合写科学内容」,不如说它的抽象层级主要是「轻量文档标记」,而科学写作本质上更接近「结构化知识建模」。
写博客了很长一段时间了,但是个人觉得,Markdown 并不适合科学写作。读研究生期间,搞搞科研,有时候会阶段性地总结一下自己的研究 idea,或者梳理自己的知识,就需要系统性地写作总结。这部分我经常写在自己的博客里,就比如之前所发表的博客内容。
我这个博客网站是基于 Markdown + Unified.js + Nuxt Content 工具链实现的,每篇博客源格式都是 markdown 写成,再编译成 HTML 发表在网页上。
但是,在写作过程中,我经常会有种非常别扭且痛苦的感觉。前几天写了一篇文章,因果结构模型简论,这是一篇偏学术和展开论述的文章。
但是把它们写成 Markdown 博客,却花了我几乎两周的时间去校对和验证。最后精力不支,只能交给 LLM 后仓促发表。类似的,再撰写这类科学写作的文章,Markdown 让我深深感受到了这种文档的不足和局限。
写作对工具不挑剔,但工具的选择会悄悄影响你写作的组织方式。用记事本写,你倾向于纯线性;用 Notion 写,你可能会不自觉地建数据库、打标签;用 Markdown 写,你会习惯用标题层级来切分内容。
一般来说,写作分为几种类型:日常写作、科学写作、技术写作。
三者虽然都叫「写作」,但是背后所使用的行文组织、写作思路等完全不同。使用的认知模型完全不同。
它们对「段落」「证据」「结构」「读者」的预设都不一样。Markdown 的流行,很大程度上是因为它恰好适配了技术写作和一部分日常写作,但科学写作的核心需求它确实覆盖得很差。
Markdown 与其说「不适合写科学内容」,不如说它的抽象层级主要是「轻量文档标记」,而科学写作本质上更接近「结构化知识建模」。
日常写作
首先是日常写作。 日常写作在互联网上随处可见,比如我们写的沟通、记录、表达。比如邮件、笔记、社交媒体、日记等等,它的核心是「交流感受、讲述经验、维持关系」。读者一般是自己或熟人,共享大量语境。
日常写作是「线性的」。比如:
今天去了一趟实验室,发现服务器又挂了。折腾了半天,最后发现是 CUDA 环境的问题。
这样的好处,就是随意、口语化、结构松散,容错率高,歧义靠语境补全。
它的基本结构就是:想法 → 句子 → 段落 → 文章。
Markdown 对这种东西非常舒服。标题、粗体、列表、引用,已经足够了。而且这个链条是单向、可增量的。写一段是一段,不必先有全局骨架。这些已经覆盖了日常写作 90% 的标记需求。日常写作本来也不需要那么精确的视觉层级。
更重要的是,Markdown 的纯文本性让它在任何设备、任何编辑器里都能打开和修改。手机备忘录、VS Code、Obsidian、Notion、Typora,甚至 GitHub 的 issue 框,都能写。这种低门槛 + 跨平台,正好匹配日常写作「随时随地、随手就写」的场景。
它允许模糊、跳跃、情绪化,结构常常是情绪曲线或联想链条。博客、散文、社交媒体都属于这一类。Markdown 在这里够用,因为它只需要轻量地标记标题、列表、强调、链接。
作者不需要预先设计结构,想到哪写到哪。读者也不指望从中提取精确知识,能跟上情绪和大致信息就行。逻辑跳了、指代不清、重复啰嗦,都不致命,语境会补全。改一句话不影响全局,不需要回头调整编号、引文、交叉引用。
所以,对于日常写作,工具要求实际上并不高,任意文本编辑器、笔记软件如 MS Word,Evernote,Notion 都可以轻松应对,甚至手机自带的笔记本 App,Windows 文本编辑器都能应对。
日常写作还有一个特点:结构可以后补。你先随手写一堆碎片,之后再整理成「标题 + 段落 + 列表」,完全来得及。因为日常写作不依赖精确的交叉引用和编号,结构调整不会引发连锁修改。
所以,日常写作是三种写作里对工具最宽容、对结构最随意、对修改最不敏感的一类。Markdown 在这里如鱼得水,不是因为它多强大,而是因为日常写作本来就不需要多强大。
技术写作
其次是技术写作。 技术写作的核心是「让读者完成操作或理解系统」。回答「怎么做」。比如 API 文档、用户手册,核心是让读者准确、高效地完成操作,追求可用性和任务完成率。
它追求可检索、可复用、可版本控制、可多端发布。文档、API 说明、教程、README 是典型。大多数开源项目的文档、技术博客等等,都属于这种类型。
技术写作是「操作性的」。技术文档的写作内容,更像是目标、环境、安装、配置、运行、错误处理、结果一连串起来。
文章的每个部分都是任务导向,模块化。比如,读者可跳读。且每个部分都可以在自己的内部领域展开——这就是典型的树形文章组织。
因此 Markdown 的标题树非常自然,以一个开源项目的 Github Readme 文档的组织结构为例:
# Installation
## Requirements
## Install
# Usage
# Troubleshooting
例如,如果读者已经 install 了这个软件,就可以直接跳过 installation 和 requirements 这两章节,直接跳转到 Usage 章节。
Markdown 的核心模型是树状文档——标题下挂段落和列表,段落和列表之下再无更深的语义结构。就像这样:
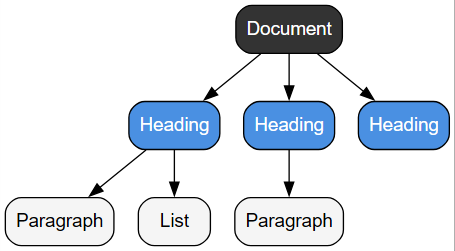
Markdown 几乎是为这类写作量身定做的:纯文本、易 diff、易转 HTML、易嵌入代码块。技术写作的「正确性」往往由代码运行结果或操作是否成功来验证,不需要复杂的引注和排版。Markdown 的设计目标不是「表达知识结构」,而是「让纯文本容易读、容易写、容易转 HTML」。它的语法元素——标题、列表、强调、链接、代码块、引用——本质上都是视觉标记,不是语义对象。
所以 Markdown 甚至非常适合技术写作。例如 GitHub README、API 文档、开发文档,本质上就是让一个人沿着信息路径完成一个任务。
科学写作
但科学写作不是信息排列,而是在构造一个可以被检验的论证系统。核心是提出假设、展示证据、论证结论。
这一点在技术写作和科学写作里就完全不同了。技术写作的结构往往是预先设计的,科学写作的结构更是由论证逻辑和引用关系约束的。一旦结构变了,引文、图表编号、交叉引用都要跟着变。
以写一篇论文为例,真正的逻辑并不是「Introduction → Method → Experiment → Conclusion」这样的排版顺序,而更接近:先有一个现象,再追问为什么现有解释不足,进而提出新的问题表述,建立数学模型,推导出模型应当具有的可验证性质,设计方法去利用这个性质,用实验去验证这些性质是否真的存在,检验方法是否真正解决了问题,最后排除其他可能的解释。
这条链条可以进一步抽象为 Claim → Assumption → Model → Derivation → Prediction → Evidence → Conclusion,这已经不是普通意义上的「文档结构」,而更像一张证明图、因果图或知识图。
由此可以看到,科学写作其实存在两套结构。读者看到的是表层结构,也就是论文的 IMRaD 结构(引言 - 方法 - 结果 - 讨论),这一线性过程:Introduction、Related Work、Method、Experiments、Conclusion。
但真正决定论文质量的是深层结构——从 Research Question 出发得到 Claim,Claim 一边连接 Assumption,一边连接 Evidence,Assumption 导向 Model,Evidence 来自 Experiment 并与 Model 互相印证,Model 产生 Prediction,最终汇聚为 Conclusion。
一个好的论文段落内部也遵循类似的链条:Claim → Reason → Evidence → Interpretation → Connection to next claim。这种写作模型如下图所示
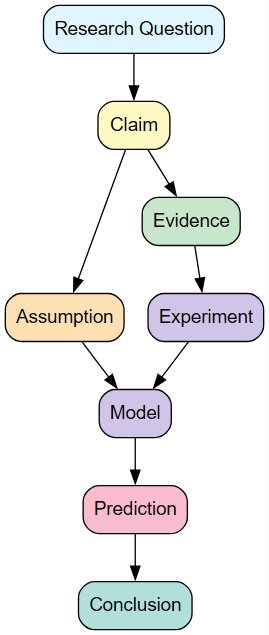
可以说,科学论文本质上非常接近一种有向图结构,这就产生了一个有意思的矛盾:Markdown 擅长表达「文档树」,而科学写作真正需要表达的是「论证图」。这条链条在认知科学和论证理论里也有对应。比如 Toulmin 的论证模型:Claim、Ground、Warrant、Backing、Qualifier、Rebuttal。
这也是为什么 在科学写作中显得格外强大,且在 互联网时代 Markdown 盛行的情况下仍然未被淘汰的原因。
表面上看起来比 Markdown 古老得多,但它解决的其实不只是排版问题,它隐含的是 科学对象是一等公民 这样一种思想。 内置的 equation、theorem、lemma、proof、definition、figure、table、citation、cross-reference、appendix 等等组件,这些东西在 里不是普通文本,而是具有实际意义的科学对象(Object)。在科学写作中,讲论证图组织起来的方式,就是 \ref 各个科学对象。
写一个公式并加上 \label{eq:loss},再用 \ref{eq:loss} 去引用它,本质上不是在说「这里有一段数学」,而是在声明这是一个具有编号、引用关系和语义身份的 Equation。此外,在科学写作中,定理环境(theorem)也是很重要的,有时候我会在展开论述的时候,给出一些定义、推论、引理等等。在其他文章部分,会经常 refer 到这些。这样一来,文中就建立起了知识对象之间的引用关系,这已经比 Markdown 里单纯加粗一个 Loss function 高了一个抽象层次。
而仅 Markdown 则完全做不到这些。在进行科学写作的时候,只能手动去标注哪些是「定理」,用到了哪些部分,然后再手动写出引用位置,实在无法做到随心所欲去 refer 每一个对象。这些对象和关系,在 LaTeX 编译时会被自动编号、自动解析、自动维护。你增删一个公式,所有引用它的地方都会自动更新。这就是「图结构」在工具层面的体现。Markdown 没有这些语义对象。你只能手动写「如公式 (3) 所示」,然后手动维护编号。一旦增删,就是灾难。
更麻烦的是,科学写作并不是一日之功,很多时候要经过好几天甚至数月时间才能写成文章,在此期间,校对、增删文章时都会重构整个对象引用关系,如果论述过程简单还尚可,对系统性长文,手动维护各个对象之间的关系,简直是灾难级别的事故。
我个人也尝试去寻找相关工具链,很遗憾,我没有找到任何能适用于科学写作处理的 Markdown 文档工具链。
虽然社区有一些尝试,比如 Pandoc 的 Markdown 扩展、Quarto、MyST、Jupyter Book,它们确实支持公式、引用、交叉引用。但它们的抽象层级仍然是「文档 + 一些科学标记」,而不是「科学知识图」。它们能让你在 Markdown 里写公式和引用,但无法让你像 LaTeX 那样自然地声明和引用定理、引理、证明、假设、证据。
更重要的是,它们没有解决上面提到的核心问题:科学写作的深层结构是图,而不是树。工具如果只提供树形结构,写作者就只能手动在脑子里维护图,然后把它压扁成树。这个「压扁」过程,就是让我觉得别扭和痛苦的根源。
压扁的代价
上面说的「压扁」不是一个比喻,它是一件有具体成本的事。
写作并不是「先在脑子里想好一张完整的图,再把它抄成文字」。真实的过程往往相反:图和文本互相塑造。你在写第三段的时候,才想清楚第一段那个 Claim 到底需要什么假设;你在写实验的时候,才发现原来的模型少了一个条件。图是在写作过程中长出来的,而 Markdown 要求你在图还没有定形的时候,就把它线性地固定下来。
举一个具体的例子。假设我在写一篇关于因果推断的文章,第三节给出了「后门准则」的定义,第五节有一个命题依赖这个定义,第七节的分析又依赖那个命题。现在我想在第三节中间再插入一个识别性假设。在 里这是一个局部操作:加一个 \label,被影响的地方编译时会提醒我。在 Markdown 里这是一次全局手术:我得记住哪些地方引用了「上面那个定义」,哪些公式的编号要变,哪些「如公式 (3) 所示」要改成 (4)。而 Markdown 不会告诉我它们在哪里。
不过编号错乱其实还不是最贵的部分,因为编辑器至少能搜到。真正贵的是关系的丢失。在 Markdown 里,「这一段是为了支持那个 Claim」这个事实不存在于文件里,它只存在于我的脑子里。今天写的时候当然记得,三个月后回来改的时候就不记得了。
这带来一个更隐蔽的后果:别人无法验证我的论证。合作者和审稿人拿到的是一段线性文本,他们只能重新读一遍全文,然后在自己脑子里把这张图重建出来,再检查它成不成立。每个人都要重建一遍。引用是显式的,论证是隐式的。
所以那种「别扭」的感觉可以更精确地描述:写作时,我的大脑同时在维护两个表征——一张还在变的论证图,和一条正在往前走的文本流——并且要保证它们在每一步都一致。Markdown 为前者提供的支撑是零。它不是不好用,是它根本没打算管这件事。
读者也在走这张图
线性化的成本不只由写作者承担,读者也在付。
读一篇论文的真实动作从来不是从头读到尾。读到中间的 Claim,我要翻回前面看那个定义到底是什么;看到「实验表明」,我要跳到结果章节确认;想知道这个结论有多强,我要去附录看证明的边界条件。阅读本身就是在图上做遍历,而且是带随机跳转的遍历。
IMRaD 与其说是一种逻辑结构,不如说是一种为印刷媒介做的妥协。纸是顺序的,装订是顺序的,翻页是顺序的,所以我们把一张图压成一条线,然后指望读者自己再把它拆开、重新组装。
这里有一个有点讽刺的地方:网页其实是天然支持非线性阅读的。折叠、跳转、悬浮预览、双向链接,技术上全都存在。但我们依然在用线性的写作工具,生产线性的制品,再把它放到一个非线性的媒介上。最后得到的,是一篇被伪装成网页的 PDF。
所以「压扁」这件事,写的人付一次,读的人付一次,每个合作者再各付一次。它是一个被反复征收的成本。
有人会说,图结构的写作工具不是早就有了吗?Obsidian、Logseq、Roam Research 的双向链接,不就是图吗?
是图,但粒度不对。这些工具的节点是笔记,不是命题。[[因果推断]] 这样一条链接只说了「这两篇相关」,没有说「这篇支持那篇」还是「这篇反驳那篇」。而当边没有类型的时候,一张论证图就退化成了一个共现网络。图上只剩下相关性,可科学写作里最要紧的东西恰恰是边的类型:支持、反驳、假设、推导、检验。
Zettelkasten 也是同样的情况。它的原意是让想法自由连接、自然涌现,服务于「我该想什么」,而不是「我这个论证成不成立」。卡片之间可以链接,但链接不带论证语义。
另一个方向是 Pandoc、Quarto、MyST、Jupyter Book 这一类。它们的贡献是实打实的:让你能在 Markdown 里写公式、写 @fig:xxx 这样的交叉引用。但它们做的是把 的对象搬进 Markdown 的语法,并没有动 Markdown 的骨架。文档的骨架依然是一个标题树,对象只是挂在树上的装饰。至于「这个公式是从哪个假设推出来的」这类关系,它们依然没有地方可以放。
两个方向的工具缺的是同一样东西:它们都没有把「对象」和「关系」变成编辑器里可以直接操作的对象,也没有让文本变成这张图的一个投影。 一个是把边的类型丢了,一个是把对象降格成了树的装饰。而科学写作要求这两件事同时成立。
科学写作需要什么
如果要认真地解决这件事,工具大概需要具备以下几个性质。这是一张草图,不是一份产品方案。
第一,科学对象是一等公民。 这一点其实 已经做到了,但是其他的写作工具仍然做得不彻底。一个 Definition、一个 Assumption、一个 Claim、一条 Evidence、一个 Prediction,应该是编辑器里真实存在的对象:有稳定 ID,有类型,有内容,而不是一段被加粗的文字。类型本身携带信息——修改一个 Assumption 和修改一个 Definition,后果完全不同。
第二,边是有类型的。 supports、contradicts、assumes、derives、tests、qualifies。这是全文最核心的一条。只有节点类型和边的类型同时存在,才配叫论证图;只有节点,那是笔记库;只有无类型的边,那是共现网络。
第三,文本是图的一个投影。 意思是:论文不是唯一制品,而是某一张图在某一个视图下的渲染结果。同一张图应该能渲染成论文、组会 slides、审稿回复、以及一篇博客。现在的情况是反过来的——文字是本体的全部,图和 slides 都是它的下脚料。
第四,视图要可切换。 写作时用线性视图,检查覆盖面用大纲视图,审自己的逻辑用图视图。这三个视图必须操作同一份数据,否则又会退回到「手动同步」的老问题里。
第五,一致性检查应该上升到语义层。 编译器检查 \ref 指向的 label 是否存在,这是最浅的一层。再往上一层,工具应该能问:这个 Claim 有 Evidence 支撑吗?它的 Assumption 声明了吗?现有的 Evidence 支撑的是不是只是这个 Claim 的弱化版本?结论有没有超出实验能支持的范围?这些问题,本质上就是读者读论文时会问的那几个问题——工具应该先替他们问一遍。
为什么这件事一直没做成
既然需求这么明确,为什么没有这样的工具?因为读一张图很便宜,写一张图很贵。
一个理想的知识编辑系统,要求作者在想法还没成形的时候就声明「这个支持那个」「这个是从那个推出来的」。但正如前面说的,图是在写作过程中长出来的。要求作者提前声明关系,等于要求他在思考完成之前就交出思考的结论。这个交互本身就是反人性的。
这不是新问题。Bush 在上世纪四十年代设想的 Memex,Nelson 在六十年代提出的 Xanadu,都是「让人在非线性的知识网络里写作」的方案。它们没有普及,原因通常被归为工程难度和商业失败,但我更倾向于另一个解释:人的思维展开是序列式的,图是事后归纳出来的。 我们不是先有图再写文章,而是先写文章才发现图长什么样。任何强迫作者「先建图再写作」的工具,都会在第一步被放弃。
这反过来解释了一件我一直觉得有意思的事: 为什么活到了今天。它并不要求你放弃线性写作,它只要求你在必要的地方声明对象。你可以照常从头写到尾,只在需要的时候加一个 \label。它是一个树骨架 + 少量图边的混合体。这个折中在工程上极其成功——它把「线性写作」和「图结构」之间的冲突压到了大多数人都能接受的水平。
所以 的地位并不只是历史惯性。它在科学写作里没有被淘汰,是因为它是目前唯一一个既把对象和引用做成了语言原语、又不强迫作者放弃线性写作的系统。它的不足也在这里:图边只有引用这一种类型,而且维护成本随文章长度急剧上升——这正是文章开头我花两周校对的原因。
在工具出现之前,我现在怎么工作
没有现成工具,只能用流程凑。我目前的办法是把「图」和「文」分成两层,中间只做一次机械转换。
草图层不管顺序,只管对象和关系。给每个对象一个短 ID:
C1   后门准则可以替代 do-演算完成识别
A1   因果充分性假设(不存在未观测混杂)
A2   可交换性
M1   SCM 中图结构与分布的对应关系
D1   由 M1 + A1 推出 C1 的充分性方向
E1   洒水器模型上的模拟实验
E2   真实数据集上的估计

C1 <- supported by D1, E1
C1 <- assumes A1, A2
C1 <- contradicts 朴素相关分析
然后在成文层,把这些 ID 落成 的 \label 和 \ref。这样做的好处是:压扁只发生在最后一步,而且是可逆的——草图层始终在,任何时候都能回到图上检查。改动时先动草图层,再重新生成文本层的引用,而不是反过来。
诚实地说,这只是把痛苦从脑子里挪到了纸上,并没有消除手动维护。但它至少让「图」变成了一个可以被检查的实体,而不是一个只存在于我记忆里的东西。而且它带来一个意外的收益:这些 ID 本身,恰好可以当作和 LLM 交流的接口。
当 LLM 进入这张图
回到文章开头那个略显狼狈的结尾:那篇文章我写了两周,最后精力不支,交给了 LLM 仓促发表。
当时我把它当成一次失败。但现在回头看,它其实指出了一个更重要的变化:LLM 是历史上第一个有可能承担「图维护」这件事的东西。
前面说「写图很贵」,贵在哪里?贵在三件事:声明关系、保持一致、以及结构变动后重新检查下游。这三件事恰好都是 LLM 擅长的。它能读完一段文本后抽出隐含的 Claim 和 Evidence,能在插入新假设之后重新检查所有依赖它的结论,能在你改动一个定义时把下游的引用全部找出来。
但这里有一个前提,而且是致命的前提:LLM 在显式的图上工作,远好于在隐式的图上工作。 如果关系从来不曾落在文件里,LLM 也只能像我一样去猜,而且会猜得同样不可靠。所以「把图显式化」这件事的性质变了——它不再纯粹是作者的额外负担,而是让机器能够介入的前提。也许真正可行的分工不是「作者建图、作者维护图」,而是作者建图、机器维护图。
不过有一个反向的危险,值得单独说。LLM 天然擅长生成流畅的线性文本,它会不由自主地把你论证里的裂缝糊上。一段话读起来通顺,和这个论证成不成立,是两件完全不同的事,而 LLM 恰好最擅长制造前者。我用 LLM 校对那篇两周的文章时就吃过这个亏:它把很多衔接不畅的地方改顺了,但那些地方原本的不畅,其实是论证真的没接上。
所以 LLM 在这件事上的正确用法,是当图的审查者,而不是文本的润色者。让它问我「这个 Claim 的证据在哪里」,而不是问它「这段话怎么写得更好」。 前者会暴露问题,后者只会掩盖问题。
结语
如果把三种写作对应到三种数据结构,会看得更清楚:日常写作对应的是序列(Sequence),句子接句子,核心是语言流。技术写作对应的是树(Tree),文档下分节,节下分概念与流程,核心是信息层级,Markdown 对此非常合适。
而科学写作对应的则是图(Graph),一个 Claim 由 Evidence 支持、由 Assumption 建立基础、由 Model 推导而来、由 Experiment 加以检验,核心是命题之间的逻辑关系。到了这一层,Markdown 就开始显得太扁平了。
无论是读者还是写作者,实际上一直在追问:这个 Claim 从哪里来的?这个 Assumption 合理吗?这个公式是否真的从前面的定义推出?这个实验是否真的能够验证这个 Claim?这个结果还有没有其他解释?结论有没有超出实验能够支持的范围?所以科学写作,本质上是在维护一张 Claim、Evidence、Reasoning 三者互相印证的关系网络。
这也解释了为什么科学写作写久之后,我会逐渐不满足于 Markdown。
不是因为它不够漂亮,因为真正需要的已经不再是一个好用的文本编辑器,而是一个能够表达定义、命题、假设、推导、证据、引用和论证关系的科学知识编辑系统。
这三种数据结构也解释了前面所有具体的痛苦。序列容错,所以日常写作拿记事本就能对付;树可以局部修改,所以技术文档在 Markdown 里如鱼得水;而图一旦被压成线,每一次改动都要付出全局的代价——那两周的校对时间,大部分就是花在这里的。
所以在那个系统出现之前,我大概还会继续用 Markdown 写博客、用 写论文,并且在两者之间手动维护一张只有我自己看得见的图。这篇文章本身也是用 Markdown 写的——这大概是它最后一个恰当的讽刺。
Markdown 的问题不是它表达不了科学内容,而是它把科学内容中最重要的那部分——对象之间的论证关系——降格成了文本。